11月4日,启元具身研究中心发布世界模型仿真器PrimeSim。该产品基于预训练视频生成模型,经过“中训练、后训练”两阶段改造,具备替代传统仿真器的交互推演能力,可面向机器人操纵任务开展策略训练。相关权重、推理代码与训练代码将于11月6日开源。
仿真环境是机器人控制策略训练的重要基础,但依靠人工搭建仿真场景,难以支撑大规模落地。据启元具身研究中心介绍,理想的机器人仿真器需同时满足并行调度上万条轨迹、场景精确重置且无硬件损耗、减少跨场景工程定制、缩小与现实环境差距等要求。团队认为,仅依靠视频生成模型实现“视觉逼真”尚不充分,作为仿真底座,还需严格服从策略输出的动作指令、保持多相机视角间的几何与语义一致,并在远长于训练上下文窗口的时间跨度内维持状态连贯。
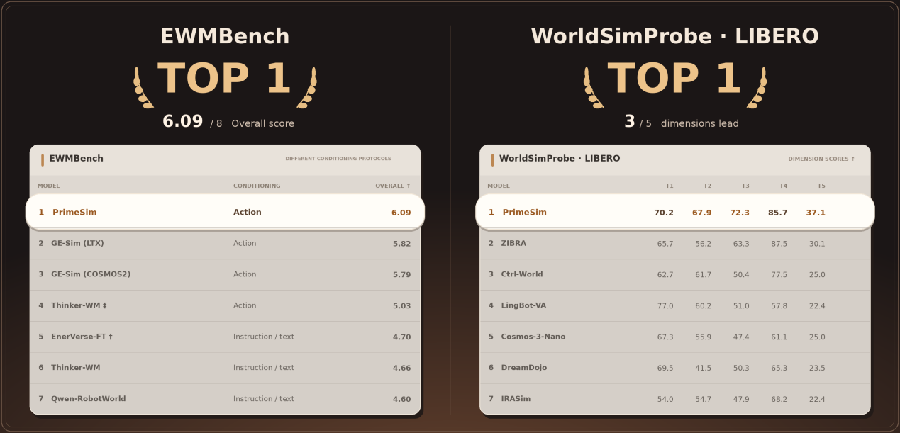
在权威基准评测中,PrimeSim表现突出。在EWMBench基准上,该仿真器以6.09的综合得分位列榜首,分项指标HSD(1.000)、nDTW(1.000)、BLEU(0.570)、CLIP(0.954)、Logics(1.000)均取得第一名。在基于LIBERO设计的WorldSimProbe五项评测中,PrimeSim在全局轨迹覆盖(67.9)、动作来源行为保持(72.3)、交互动态(37.1)三项维度登顶。
据研究团队介绍,PrimeSim采用两阶段改造范式,将原生双向视频生成模型逐步转化为可交互、可自回归滚动的世界模型仿真器。“中训练”阶段,模型基于30110小时精选机器人演示数据,覆盖人形、双臂、单臂、手持UMI设备等22种异构机器人平台,其中人形机器人样本占比54.8%、真实世界数据占比84%,并围绕统一动作表征、帧对齐双路径条件注入、视角感知交错注意力三项核心设计实现跨本体兼容与控制信号强绑定。后训练阶段,通过高速生成链路、自条件稳定性、分层时序记忆三项机制,使模型在超过固定训练上下文窗口后仍可稳定推演。
实验数据表明,在RoboTwin2.0留出集、单张A100环境下,PrimeSim经一致性蒸馏与DMD叠加,将去噪步数压缩至4步,速度由50步去噪基线的1.12FPS提升至10.04FPS,整体提速约9倍。
作为策略仿真底座,PrimeSim展现出与传统仿真器的高度对齐。实验选取8个OpenVLA-OFT策略,在300个共享初始状态设定下,PrimeSim与LIBERO原生仿真器的策略成功率相关系数达0.99,平均绝对误差为2.8。团队还直接在PrimeSim内部对策略开展GRPO强化学习,结果显示策略在原生仿真器上的成功率提升11.5%,在PrimeSim内的评估指标上涨11.8%,证明在该神经仿真器中获得的策略增益可有效迁移至传统物理仿真环境。
在少样本本体迁移方面,“中训练”赋予模型较强的跨机器人本体适配能力:适配xArm7、ViperX300、UMI夹爪分别仅需200、100、200步梯度更新。在未见于训练集的AgileXPiper场景中,经单卡A100约200步微调,布料形变即可跟随动作指令,且多视角状态保持一致。推理性能方面,在单张A100-80GB显卡、三视角输入、单图分辨率288×384的配置下,PrimeSim可实现10.12TempFPS、30.35ViewFPS的推理帧率,吞吐能力约为GE-Sim2.0的4.5倍、Ctrl-World的11.6倍。
启元具身研究中心表示,此次发布验证了通过“中训练+后训练”渐进式流水线将通用视频生成模型改造为机器人世界模型仿真器的可行性,相关成果兼顾动作保真度、长时序推演能力与工程实用性,为机器人控制策略训练的规模化提供了新路径。